
Die Bibliotheksszene aus The Time Machine kennt vermutlich fast jeder. Auf dem Weg zum virtuellen Bibliothekar wurde nun ein weiterer Schritt gemacht. Zumindest, was die Optik betrifft.
Autor: ch
"The ROI of User Experience"
Neelie Kroes: Copyright isn't working
„Is the current copyright system the right and only tool to achieve our objectives? Not really,“ Kroes said in a speech to the Forum D’Avignon thinktank. „Citizens increasingly hear the word copyright and hate what is behind it.“
[via Futurezone]
DINI-AG KIM veröffentlicht Open-Data-Empfehlungen
Die DINI-AG KIM gibt die Veröffentlichung der „Empfehlungen zur Öffnung bibliothekarischer Daten“ bekannt. Die Empfehlungen sollen bibliothekarischen Organisationen als Richtlinien und Referenz bei der Freigabe ihrer Daten dienen.
Gegenstand der Empfehlungen sind nicht nur beschreibende Metadaten, sondern sämtliche nicht-sensiblen Daten, die von bibliothekarischen Organisationen produziert werden, wie z.B. auch statistische Daten oder Zirkulationsdaten.
Die Empfehlungen benennen neun Prinzipien für offene bibliothekarische Daten. Um als ‚offen‘ im Sinne der Empfehlungen zu gelten, sind zwingend die drei Kernforderungen nach offenem Zugang, offenen Standards und offenen Lizenzen einzuhalten.
Desweiteren sollten die Daten regelmäßig aktualisiert werden und auch im Ursprungsformat vorliegen, sie sollten strukturiert beschrieben werden und möglichst ohne Registrierung zugänglich sein. Vorkehrungen für die Nachhaltigkeit der Bereitstellung sollten getroffen werden.
Die Empfehlungen orientieren sich an existierenden Open-Data-Prinzipien und -Richtlinien für Gedächtnisinstitutionen oder dem öffentlichen Sektor im allgemeinen. Einzusehen sind die Empfehlungen im Wiki der Deutschen Nationalbibliothek.
Der Text selbst ist unter einer CC0-Lizenz veröffentlicht. Seine Verbreitung und Wiederveröffentlichung ist ausdrücklich erwünscht.
Hier sind die Empfehlungen in der aktuellen Version 1.0:
Empfehlungen zur Öffnung bibliothekarischer Daten
1. Präambel
Bibliotheken und andere Informationseinrichtungen arbeiten täglich in vielfältiger Weise mit Daten unterschiedlicher Verwendungszwecke und Bestimmung. Sie agieren als Datenproduzenten, Datenlieferanten, Datennutzer und Aggregatoren. Um den größtmöglichen Nutzen der durch öffentliche Einrichtungen produzierten Daten zu gewährleisten, ist es geboten, sie offen im Internet zu publizieren.
2. Gegenstand
In Informationseinrichtungen werden verschiedene Formen von Daten produziert, die Gegenstand einer Datenfreigabe sein können. Es ist zu betonen, dass eine Datenfreigabe nur durchgeführt werden kann unter der Voraussetzung, dass
- es sich bei den jeweiligen Daten nicht um personenbezogene oder anderweitig sensible Daten handelt,
- die jeweilige Einrichtung im Besitz der Datenbankrechte bzw. ggf. der Urheberrechte ist, um die Daten freizugeben.
Unter bibliothekarischen Daten zu verstehen sind sowohl bibliographische Daten gemäß den „Prinzipien zu offenen bibliographischen Daten“ als auch darüber hinausgehende Daten, die in Ausübung bibliothekarischer Tätigkeit erstellt werden.
Zur Verwaltung der Dienstleistungen einer Bibliothek fallen zudem weitere Daten an, die – insofern es sich um nicht personenbezogene oder anderweitig sensible Daten handelt – ebenfalls freigegeben werden können. Zu diesen Daten zählen beispielsweise Exemplardaten, Erwerbungsdaten, anonymisierte Ausleihdaten, statistische Daten.
3. Prinzipien
Die DINI-AG KIM empfiehlt bibliothekarischen Einrichtungen im deutschsprachigen Raum und der gesamten Welt die Freigabe bibliothekarischer Daten. Folgende Prinzipien sind dabei zwingend einzuhalten:
- Offener Zugang zu den Daten, d.h. die Daten müssen offen und kostenlos als Gesamtheit im Web zugänglich sein.
- Offene Standards, d.h. die Daten müssen in einem offen dokumentierten und nicht-proprietären Format vorliegen. Es sind Webstandards zu bevorzugen, die von einer möglichst breiten Anwenderbasis verstanden werden.
- Offene Lizenzen, d.h. die Daten müssen (als Einzeldatum und als Sammlung) unter einer offenen Lizenz im Sinne der Open Definition publiziert werden. Dabei empfielt die DINI-AG KIM die Verwendung eines Public-Domain-Waivers wie der CC0 Public Domain Dedication oder der Public Domain Dedication and License (PDDL) um die bestmögliche rechtliche Interoperablität der Daten zu garantieren.
Darüber hinaus empfehlen wir die Berücksichtigung folgender Prinzipien:
- Dokumentation: Eine strukturierte Beschreibung der Daten soll veröffentlicht werden. Bestenfalls sollen die Daten in einem zentralen Verzeichnis (wie z.B. thedatahub.org)nachgewiesen werden.
- Rohdaten: Die Daten sollen möglichst so zugänglich gemacht werden, wie sie im Informationskreislauf der Bibliotheken anfallen. Jede weitere Filterung oder Aufbereitung wird auf diejenigen verlagert, die von den Informationen später Gebrauch machen.
- Aktualität: Daten sollen innerhalb eines angemessenen Zeitraums nach ihrer Erstellung oder Änderung veröffentlicht werden. Was angemessen ist, kann je nach Art der Daten variieren.
- Strukturiert: Die Daten sollen in einem strukturierten Format publiziert werden, das einfache maschinelle Verarbeitung ermöglicht.
- Nicht-diskriminierend: Der Zugriff auf die Daten soll für alle möglich sein, einzige akzeptable Hürde ist der Zugang zum Internet. Das heißt, dass keine Registrierung erforderlich sein soll.
- Nachhaltigkeit: Die Bereitstellung der Daten soll mit der Entwicklung eines Nachhaltigkeitskonzepts verbunden sein, dass eine dauerhafte Archivierung und den Zugriff auf ältere Versionen der Daten sicherstellt.
Selten wird die Einhaltung sämtlicher Prinzipien von Anfang an gewährleistet sein. Allerdings sind die ersten drei Prinzipien notwendige Bedingungen, um überhaupt von offenen bibliothekarischen Daten zu sprechen. Es wird ausdrücklich empfohlen, zunächst auch Rohdaten zu veröffentlichen, die womöglich nicht in einem öffentlich dokumentierten Format vorliegen und/oder nicht strukturiert oder regelmäßig aktualisiert werden. Mittelfristig soll aber an der Einhaltung sämtlicher Prinzipien gearbeitet werden.
4. Verwandte Materialien
- Prinzipien zu offenen bibliographischen Daten
- A 4-star classification-scheme for linked open cultural metadata
- Discovery Open Metadata Principles
- Definition: Offenes Wissen
- Open Bibliographic Data Guide
- Tim Berners-Lee: Linked Data
- Linked Open Data star scheme by example
- Ten Principles for Opening Up Government Information
- Working Paper: Open Government Data
- Open Definition: conformant data licenses
Entstanden im Rahmen der Gruppe Lizenzen der DINI-AG KIM.
Beitragende: Patrick Danowski, Kai Eckert, Christian Hauschke, Adrian Pohl und andere

Der Text dieser Empfehlungen ist unter der Creative Commons Lizenz CC0 veröffentlicht. Er ist somit gemeinfrei, d.h. er gehört allen und darf zu beliebigen Zwecken und ohne Auflagen genutzt werden. Bei Nachnutzung wird die Nennung der Quelle erbeten.
Citogenesis
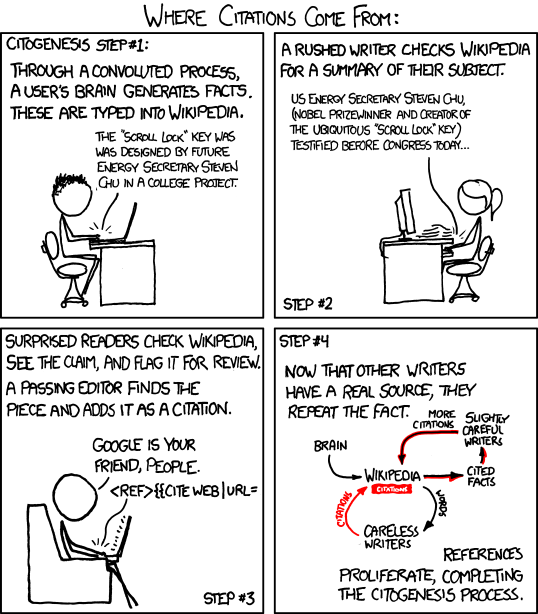
Ceterum censeo: Wer noch keinen Wikipedia-Artikel angelegt oder zumindest bearbeitet hat, sollte Medien- oder Informationskompetenz nicht unterrichten dürfen.
[via XKCD]
Mythos buchfreie Bibliothek
Barbara Fister macht sich in Inside Higher Ed Gedanken über die buchfreie Bibliothek:
No matter how innovative the bookless library sounds, this isn’t a situation we planned. If the academic library of the future is bookless, it won’t be because of vision. It will be because of the lack of it.
Mit Buch ist hier die Papierversion gemeint. Mehr im Artikel: The Myth of the Bookless Library.
Linked Library of Congress
Adrian Pohl hat in seiner Stimme für Plan3t.info wieder vier Links parat, diesmal unter anderem auf die Ankündigung der Library of Congress, ein Bibliographic Framework for the Digital Age zu entwickeln. Dazu schreibt er:
Für viel Aufsehen hat die Ankündigung der Library of Congress gesorgt, ein ‘bibliographic framework’ für das digitale Zeitalter zu entwickeln, das auf RDF Linked-Data-Standards setzt. Nun wird es also für all jene Zeit, die Linked Data bisher als vorübergehenden Hype verstanden haben, sich mit den Ideen dahinter auseinanderzusetzen. Die Ankündigung wirft zunächst eine Menge Fragen auf, wie z.B.: Welche Vokabulare/Ontologien werden für die RDF-Repräsentation bibliographischer Information empfohlen? Wie wird RDA hierfür weiterentwickelt? Auf der Mailingliste Bibframe werden diese und andere Fragen eifrig diskutiert.
Da in der Bibliothek der FH Hannover gerade Überlegungen laufen, eine Hochschulbibliographie auf LOD-Basis aufzubauen, wird sich das Thema hier in Zukunft sicherlich regelmäßig finden. Die oben erwähnte „RDF-Repräsentation bibliographischer Information“ ist dabei natürlich besonders interessant. Wer sich mal ansehen möchte, wie das aussehen könnte, dem sei BIBO empfohlen, die Bibliographic Ontology. Die Beschreibung eines Artikels sieht dort beispielsweise so aus.
Die im Beispiel verwendete RDF-Schreibweise nennt sich Turtle (Terse RDF Triple Language). Wer sich für RDF interessiert, dem möchte ich dringend nahelegen: Macht einen weiten Bogen um die XML-Schreibweisen und seht Euch direkt alles in Turtle an. Das ist menschenlesbar und schon mit sehr wenig Übung tatsächlich auch schreibbar. Ein ganz nettes Tutorial zu Turtle gibt es im Haystack Blog. Links zu anderen, vielleicht besseren Tutorials im LOD-Kontext nehme ich gerne entgegen!
"Sign here!"
Edlef hat mich dankenswerterweise in einem Kommentar auf eines seiner Netbib-Postings hingewiesen. Dort ist folgendes Video zu sehen:
„Sign here?“
Unbedingt angucken und weiterverteilen, liebe Open-Access-Freunde!
Das Video wurde anscheinend auf Xtranormal.com erstellt, einem Dienst ganz ähnlich dem kürzlich vorgestellten GoAnimate.
Siri und die Bibliotheken
Mark Buzinkay überlegt, welche Folgen die Spracherkennungssoftware Siri für Bibliotheken haben könnte:
Eine der häufigsten und zeitaufwändigsten Aufgaben eines Bibliotheksnutzers ist das Recherchieren im Bibliotheksbestand. Recherchen in diesen Oberflächen (Web-Opac, Primo, etc.) sind nicht trivial, so dass Bibliotheken gar Nutzerschulungen anbieten. Nun kommt Siri und empfängt meinen mündlichen Befehl, die wichtigsten 10 Titel zum Thema “Spracherkennungssoftware” zu entlehnen. Anstatt also selbst in die Tasten zu klopfen, Literaturverzeichnisse, Rezensionen etc. durchzukämmen, um nicht nur Titel sondern auch deren Bedeutung in der wissenschaftlichen Diskussion festzustellen, bedient sich Siri entsprechender Partnerdienste, die über entsprechende Daten verfügen.
Mehr im MBI-Blog.
Interview zur Öffnung bibliothekarischer Daten
Adrian Pohl wurde für das Open-Data-Blog der Zeit interviewt. Unbedingt lesenswert! Es geht um Open Bibliographic Data, also die Veröffentlichung bibliographischer Daten unter freier Lizenz.
Sammlungen bibliographischer Daten können als eine Landkarte verstanden werden, die uns Orientierung gibt in der Landschaft unserer literarischen, wissenschaftlichen oder künstlerischen Erzeugnisse.
So können die Daten etwa in der Forschung genutzt werden. Für Historiker beispielsweise könnte die Frage interessant sein, in welchem Jahrhundert zu bestimmten Zeiten wo wichtige Publikationsorte waren. Mit automatisierten Abfragen offener Daten aus Bibliothekskatalogen ließe sich zügig eine Übersicht über die meistgenutzten Publikationsstandorte erstellen. Das ginge weit über das hinaus, was mit normalen Rechercheoptionen möglich ist.
Ein anderes Beispiel: Bibliotheksdaten werden bereits für Anwendungen genutzt, die den urheberrechtlichen Status eines Werkes berechnen, ob es geschützt oder gemeinfrei ist. Mehr freie Daten könnten diese Dienste enorm verbessern. Es lassen sich unzählige weitere Anwendungen denken.
Dabei verweist er auch auf die „Empfehlungen zur Öffnung bibliothekarischer Daten“ [1] Disclaimer: Ich bin Mitverfasser. , auf deren vorläufige Fassung Edlef Stabenau letztens schon hingewiesen hatte.
References
| ↑1 | Disclaimer: Ich bin Mitverfasser. |
|---|