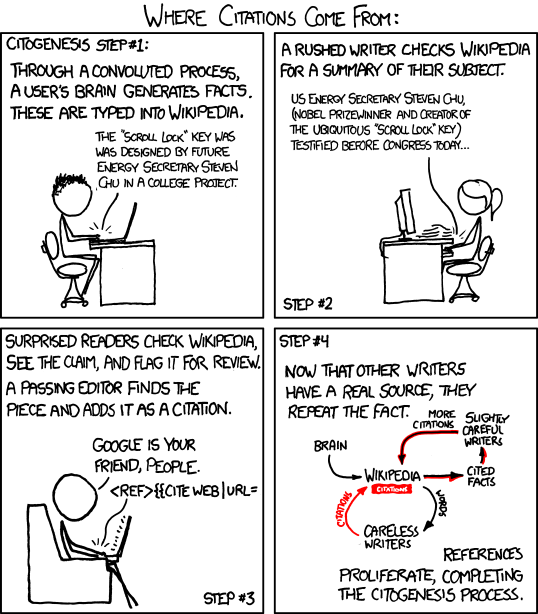
Ceterum censeo: Wer noch keinen Wikipedia-Artikel angelegt oder zumindest bearbeitet hat, sollte Medien- oder Informationskompetenz nicht unterrichten dürfen.
[via XKCD]
Interessantes aus Informations- und Bibliothekswesen

Ceterum censeo: Wer noch keinen Wikipedia-Artikel angelegt oder zumindest bearbeitet hat, sollte Medien- oder Informationskompetenz nicht unterrichten dürfen.
[via XKCD]
Barbara Fister macht sich in Inside Higher Ed Gedanken über die buchfreie Bibliothek:
No matter how innovative the bookless library sounds, this isn’t a situation we planned. If the academic library of the future is bookless, it won’t be because of vision. It will be because of the lack of it.
Mit Buch ist hier die Papierversion gemeint. Mehr im Artikel: The Myth of the Bookless Library.
Adrian Pohl hat in seiner Stimme für Plan3t.info wieder vier Links parat, diesmal unter anderem auf die Ankündigung der Library of Congress, ein Bibliographic Framework for the Digital Age zu entwickeln. Dazu schreibt er:
Für viel Aufsehen hat die Ankündigung der Library of Congress gesorgt, ein ‘bibliographic framework’ für das digitale Zeitalter zu entwickeln, das auf RDF Linked-Data-Standards setzt. Nun wird es also für all jene Zeit, die Linked Data bisher als vorübergehenden Hype verstanden haben, sich mit den Ideen dahinter auseinanderzusetzen. Die Ankündigung wirft zunächst eine Menge Fragen auf, wie z.B.: Welche Vokabulare/Ontologien werden für die RDF-Repräsentation bibliographischer Information empfohlen? Wie wird RDA hierfür weiterentwickelt? Auf der Mailingliste Bibframe werden diese und andere Fragen eifrig diskutiert.
Da in der Bibliothek der FH Hannover gerade Überlegungen laufen, eine Hochschulbibliographie auf LOD-Basis aufzubauen, wird sich das Thema hier in Zukunft sicherlich regelmäßig finden. Die oben erwähnte „RDF-Repräsentation bibliographischer Information“ ist dabei natürlich besonders interessant. Wer sich mal ansehen möchte, wie das aussehen könnte, dem sei BIBO empfohlen, die Bibliographic Ontology. Die Beschreibung eines Artikels sieht dort beispielsweise so aus.
Die im Beispiel verwendete RDF-Schreibweise nennt sich Turtle (Terse RDF Triple Language). Wer sich für RDF interessiert, dem möchte ich dringend nahelegen: Macht einen weiten Bogen um die XML-Schreibweisen und seht Euch direkt alles in Turtle an. Das ist menschenlesbar und schon mit sehr wenig Übung tatsächlich auch schreibbar. Ein ganz nettes Tutorial zu Turtle gibt es im Haystack Blog. Links zu anderen, vielleicht besseren Tutorials im LOD-Kontext nehme ich gerne entgegen!
Edlef hat mich dankenswerterweise in einem Kommentar auf eines seiner Netbib-Postings hingewiesen. Dort ist folgendes Video zu sehen:
„Sign here?“
Unbedingt angucken und weiterverteilen, liebe Open-Access-Freunde!
Das Video wurde anscheinend auf Xtranormal.com erstellt, einem Dienst ganz ähnlich dem kürzlich vorgestellten GoAnimate.
Mark Buzinkay überlegt, welche Folgen die Spracherkennungssoftware Siri für Bibliotheken haben könnte:
Eine der häufigsten und zeitaufwändigsten Aufgaben eines Bibliotheksnutzers ist das Recherchieren im Bibliotheksbestand. Recherchen in diesen Oberflächen (Web-Opac, Primo, etc.) sind nicht trivial, so dass Bibliotheken gar Nutzerschulungen anbieten. Nun kommt Siri und empfängt meinen mündlichen Befehl, die wichtigsten 10 Titel zum Thema “Spracherkennungssoftware” zu entlehnen. Anstatt also selbst in die Tasten zu klopfen, Literaturverzeichnisse, Rezensionen etc. durchzukämmen, um nicht nur Titel sondern auch deren Bedeutung in der wissenschaftlichen Diskussion festzustellen, bedient sich Siri entsprechender Partnerdienste, die über entsprechende Daten verfügen.
Mehr im MBI-Blog.
Adrian Pohl wurde für das Open-Data-Blog der Zeit interviewt. Unbedingt lesenswert! Es geht um Open Bibliographic Data, also die Veröffentlichung bibliographischer Daten unter freier Lizenz.
Sammlungen bibliographischer Daten können als eine Landkarte verstanden werden, die uns Orientierung gibt in der Landschaft unserer literarischen, wissenschaftlichen oder künstlerischen Erzeugnisse.
So können die Daten etwa in der Forschung genutzt werden. Für Historiker beispielsweise könnte die Frage interessant sein, in welchem Jahrhundert zu bestimmten Zeiten wo wichtige Publikationsorte waren. Mit automatisierten Abfragen offener Daten aus Bibliothekskatalogen ließe sich zügig eine Übersicht über die meistgenutzten Publikationsstandorte erstellen. Das ginge weit über das hinaus, was mit normalen Rechercheoptionen möglich ist.
Ein anderes Beispiel: Bibliotheksdaten werden bereits für Anwendungen genutzt, die den urheberrechtlichen Status eines Werkes berechnen, ob es geschützt oder gemeinfrei ist. Mehr freie Daten könnten diese Dienste enorm verbessern. Es lassen sich unzählige weitere Anwendungen denken.
Dabei verweist er auch auf die „Empfehlungen zur Öffnung bibliothekarischer Daten“ [1] Disclaimer: Ich bin Mitverfasser. , auf deren vorläufige Fassung Edlef Stabenau letztens schon hingewiesen hatte.
References
| ↑1 | Disclaimer: Ich bin Mitverfasser. |
|---|
GoAnimate ist ein Webdienst, mit dem man kleine oder auch größere Zeichentrickfilmchen sehr einfach zusammenklicken kann. Es stehen zwei deutsche Stimmen zur Verfügung, die man auswählen kann. In der kostenlosen Version ist die Zahl der Charaktere stark begrenzt, aber man könnte problemlos kleinere PR-Filmchen für Bibliotheken zusammenklicken. Als recht sinnfreies 1,5-Minuten-Beispiel (Erstellungszeit, Abspielzeit etwa 30 Sekunden) habe ich dies hier erstellt:
Bibliotheksbesuch ist eine Belohnung! by CH_
Hier ein Beispiel, wo GoAnimate für eine kleine Bibliothekseinführung verwendet wurde:
Ein weiteres, schon etwas älteres Beispiel findet sich hier bei Bibliothekarisch.de: You’re a librarian. Wie sieht’s aus, werte KollegInnen? Schaffen wir es, ein paar Beispiele für gelungene Bibliotheksvideos zu sammeln? Klickt, schreibt, verlinkt (am Besten unten in den Kommentaren)!
Der Einzelhandelskonzern Amazon hat sein E-Book-Angebot in den USA erwartungsgemäß um einen Verleih erweitert. Kunden des Premiumdienstes Amazon Prime bekommen Zugriff auf gegenwärtig rund 5000 Titel, einem Bruchteil des über 800.000 E-Books starken Angebots im US-amerikanischen Kindle Store. Darunter befinden sich laut Amazon 100 aktuelle oder ehemalige New-York-Times-Bestseller, in Summe umfasst das Leihangebot jedoch hauptsächlich eher weniger bekannte Werke.
[via Heise]
Adrian Pohl machte in Inetbib auf den Leitfaden „Open Data – Freigabe von Daten aus Bibliothekskatalogen“ (PDF) von Till Kreutzer aufmerksam:
National wie international veröffentlichen immer mehr bibliothekarische Organisationen Daten aus ihren Katalogen als Open Data. Ein Hemmnis bei der Freigabe von Katalogdaten sind jedoch oft vielfältige, zum Teil komplexe rechtliche Fragen, die für die Akteure erhebliche Herausforderungen bedeuten. Der Leitfaden soll hierbei Orientierung geben. Er richtet sich in erster Linie an Mitarbeiterinnen und Mitarbeiter von Bibliotheken der öffentlichen Hand und dabei insbesondere an Nicht-Juristen. Bei der Erarbeitung wurde besonders auf eine allgemeinverständliche Darstellung und Sprache geachtet.
Teil 1 des Leitfadens beschäftigt sich maßgeblich mit rechtlichen Fragen bei der Erstellung von Katalog-Datenbanken: Dabei wird aus rechtlicher Sicht erläutert, ob und, wenn ja, unter welchen Voraussetzungen, einzelne Daten und Angaben urheberrechtlichen Schutz genießen können. Im Anschluss wird untersucht, unter welchen Umständen Anbietern von Katalogdaten neben einem urheberrechtlichen Schutz an den einzelnen Daten ein Schutzrecht an der Gesamtheit der Daten (sogenanntes Datenbankrecht) zustehen kann.
Teil 2 des Leitfadens nimmt sich der Frage an, unter welchen Bedingungen eine von der Bibliothek rechtmäßig erstellte Datenbank im Sinne von Open Data genutzt werden kann. Der Leitfaden schließt mit Empfehlungen zur Auswahl von Open-Data-Lizenzen.
Weitere Infos bei iRights.info.
Jemand (Najko Jahn?) hat im Libreas-Blog kürzlich vorgestellt, wie man OpenCPU nutzen kann, um sich ein eigenes Tweet-Archiv anzulegen und dies auch gleich zu visualisieren. Er/sie tat dies am Beispiel #oebt11. Hier ein anderes Beispiel, die aktuell durchgeführte Library 2.011:
CSV dazu:
http://beta1.opencpu.org/R/call/store:tmp/8f81a308a4f8898f0aff6ba41bead5e4/csv?tag=“lib2011″
Einige Tweets sind tatsächlich mit dem Datum 26. – 30.11. versehen. Wo der Fehler liegt, vermag ich nicht zu sagen.
Update, siehe Kommentare: